En ASIR, la alta disponibilidad no se da como un tema aislado con ese nombre — se va colando en varios sitios: cuando estudias RAID, cuando ves los SAI, cuando montas copias de seguridad. Solo cuando juntas esas piezas te das cuenta de que todas responden a la misma pregunta: ¿cómo consigo que un sistema siga funcionando aunque algo falle?
Qué es la alta disponibilidad, en una frase
La alta disponibilidad (HA, High Availability) es la capacidad de un sistema de seguir prestando servicio aunque falle alguno de sus componentes. No se trata de que nada falle nunca (eso es imposible), sino de que, cuando algo falla, el servicio no se caiga con ello.
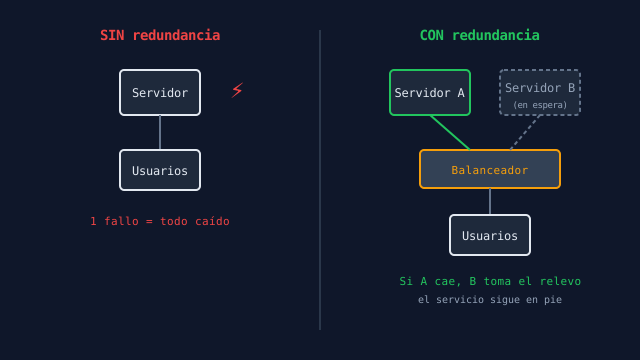
La idea de fondo que sostiene toda la alta disponibilidad es una sola: redundancia. Tener más de una copia de lo importante, para que si una falla, otra tome el relevo.
El concepto clave: el punto único de fallo
Un punto único de fallo (SPOF, Single Point of Failure) es cualquier componente que, si falla, tumba todo el sistema. El objetivo de la alta disponibilidad es eliminar los puntos únicos de fallo añadiendo redundancia donde haga falta.
Es la misma idea que veíamos en las topologías de red: un switch central del que cuelga toda la red es un punto único de fallo. En alta disponibilidad, la pregunta constante es: “si esto se rompe, ¿se cae todo? Entonces necesito una segunda vía.”
Las tres piezas que ya conoces de ASIR, vistas como alta disponibilidad
1. RAID — redundancia del almacenamiento
RAID protege frente al fallo de un disco duro. En lugar de guardar los datos en un solo disco (punto único de fallo), los reparte o los duplica entre varios, de modo que si uno muere, no se pierde nada y el sistema sigue funcionando.
| Nivel RAID | Qué hace | Tolera |
|---|---|---|
| RAID 1 | Espejo: copia idéntica en dos discos | El fallo de 1 disco |
| RAID 5 | Reparte datos + paridad entre 3 o más discos | El fallo de 1 disco |
| RAID 6 | Como RAID 5 pero con doble paridad | El fallo de 2 discos a la vez |
Un matiz importante que se aprende pronto y se olvida fácil: RAID no es una copia de seguridad. RAID protege contra el fallo físico de un disco, pero si borras un archivo por error, ese borrado se replica en todos los discos al instante. RAID te protege del hardware, no de ti mismo.
2. SAI — redundancia de la energía
Un SAI (Sistema de Alimentación Ininterrumpida, o UPS en inglés) es una batería que se coloca entre la red eléctrica y los equipos. Si se va la luz, el SAI mantiene los equipos encendidos durante un tiempo — el suficiente para:
- Apagar los equipos de forma ordenada en lugar de un corte brusco (que puede corromper datos o dañar el hardware).
- Aguantar un microcorte de unos segundos sin que el servidor se reinicie.
- Dar tiempo a que arranque un generador en instalaciones grandes.
En las prácticas de empresa esto se ve claro: un servidor que se apaga de golpe por un corte de luz puede quedar con la base de datos corrupta. El SAI convierte un corte brusco en un apagado controlado — o directamente lo evita si el corte es corto.
3. Copias de seguridad — redundancia de los datos en el tiempo
Las copias de seguridad (backups) protegen contra algo que ni RAID ni el SAI cubren: perder los datos por error humano, ransomware, o un desastre físico (incendio, robo, inundación). Es la única de las tres que te permite volver atrás en el tiempo a un estado anterior.
La regla más conocida para hacerlas bien es la regla 3-2-1:
| Número | Significa |
|---|---|
| 3 | Al menos 3 copias de tus datos |
| 2 | En 2 tipos de soporte distintos (por ejemplo, disco y nube) |
| 1 | Con 1 copia fuera del sitio físico (por si hay incendio o robo) |
Cómo se relacionan las tres (y por qué necesitas las tres)
Es un error común pensar que con una de ellas basta. En realidad cada una cubre un tipo de fallo distinto, y las tres se complementan:
| Amenaza | ¿RAID protege? | ¿SAI protege? | ¿Copia protege? |
|---|---|---|---|
| Se rompe un disco duro | Sí | No | Sí (pero con pérdida de lo reciente) |
| Se va la luz de golpe | No | Sí | No |
| Borras un archivo por error | No | No | Sí |
| Ransomware cifra los datos | No | No | Sí (si la copia está aislada) |
| Se incendia la sala de servidores | No | No | Sí (si hay copia externa) |
La conclusión que saqué al juntar todo esto: RAID te mantiene funcionando ante un fallo de hardware, el SAI ante un fallo de energía, y las copias te salvan de todo lo demás — incluido de ti mismo. No compiten, se necesitan.
Un paso más: redundancia de servidores completos
En entornos más grandes, la redundancia no se queda en los discos: se duplican servidores enteros. Dos conceptos que aparecen aquí:
- Clúster de conmutación por error (failover): dos servidores, uno activo y otro en espera. Si el activo cae, el de reserva toma el relevo automáticamente. Es lo que se ve en el diagrama de arriba.
- Balanceo de carga: varios servidores trabajando a la vez, repartiéndose las peticiones. Además de dar redundancia (si uno cae, los otros siguen), reparte el trabajo para que ninguno se sature.
Pon a prueba lo que has entendido
Borras un archivo importante por error. ¿Cuál de estas medidas te permite recuperarlo?
Resumen rápido
- Alta disponibilidad = que el servicio siga en pie aunque falle un componente. Su base es la redundancia.
- El enemigo es el punto único de fallo: cualquier pieza que, al romperse, lo tumba todo.
- RAID da redundancia al almacenamiento (fallo de disco), el SAI a la energía (corte de luz), y las copias de seguridad a los datos en el tiempo (error humano, ransomware, desastre).
- Ninguna sustituye a las otras: RAID no es una copia de seguridad, y una copia no te mantiene encendido durante un apagón. Se necesitan las tres.